

Suche
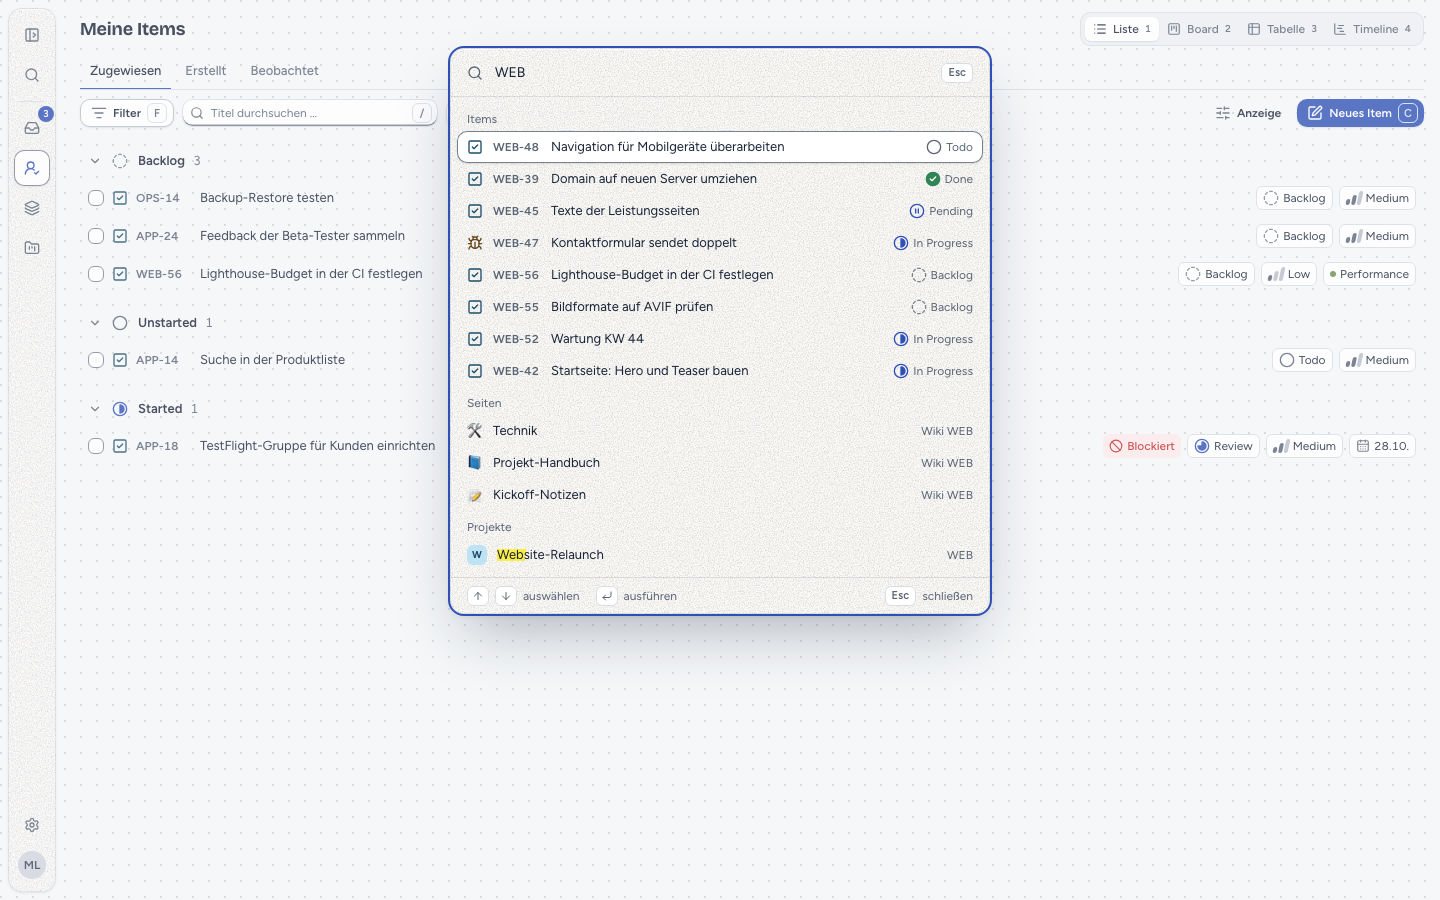
Eine Suche findet Work Items, Wiki-Seiten, Projekte, Personen und Bots sowie Views. In der Oberfläche steckt sie in der Befehlspalette (⌘ / Strg+K), über die API ist es GET /api/v1/search. Beide suchen gleich und lassen dieselben Items, Seiten, Projekte und Konten weg; die Palette fragt nach weniger Treffern je Art (8), zeigt Personen und Bots nur Org-Admins (siehe unten) und lässt das Archiv aus, außer ein Item, dessen Key du tippst. Der Browser spricht nie selbst mit der Suchmaschine: Jede Suche läuft über werkbuch, und werkbuch entscheidet, was du sehen darfst.
Was gefunden wird
| Art | Gefunden über | Ein Treffer in der Palette öffnet |
|---|---|---|
| Work Items | Key, Titel, Text der Beschreibung und der Kommentare | Die Item-Seite |
| Wiki-Seiten | Titel, Text | Die Seite im Wiki |
| Projekte | Kennung, frühere Kennungen, Name, Beschreibung | Die Item-Liste des Projekts |
| Personen und Bots | Name, Handle | Die Einstellungen Personen bzw. Bots (nur für Org-Admins, siehe unten) |
| Views | Name | Die View |
Jedes getippte Wort muss vorkommen; das letzte darf der Anfang eines Worts sein, kontakt findet also „Kontaktformular sendet doppelt“. Ab fünf Buchstaben verzeiht die Suche einen kleinen Tippfehler in Titel, Beschreibung oder Kommentar (kontaktfromular), nie in Keys, Kennungen und Handles. Ein Treffer im Key zählt mehr als einer im Titel, einer im Titel mehr als einer in der Beschreibung und einer in der Beschreibung mehr als einer in einem Kommentar; bei gleichen Treffern steht das zuletzt geänderte Item vorn (ein neuer Kommentar zählt nicht als Änderung des Items und rückt es nicht nach vorn).
Ein Wort eines Kommentars findet das Item, zu dem der Kommentar gehört; die Suche liest die Kommentare eines Items in der Reihenfolge, in der sie geschrieben wurden, bis zu 64 KB Text je Item. Ein bearbeiteter oder gelöschter Kommentar ändert die Suche einen Moment später, wie jede andere Änderung; Reaktionen ändern nichts.
Eine Wiki-Seite wird über ihren Titel und ihren Text gefunden, bis zu 64 KB Text je Seite; ein Treffer im Titel zählt mehr als einer im Text, und bei gleichen Treffern steht die zuletzt geänderte Seite vorn. Speichern, Verschieben und Löschen einer Seite ändern die Suche einen Moment später.
Ein Verweis auf ein Item in einer Seite zählt für die Suche nicht: Die Seite wird über den Key des Items, auf das sie verweist, nicht gefunden, denn ein Key als Verweis steht ohne seine Buchstaben im Text. Welche Seiten ein Item nennen, zeigt das Item selbst: Sein Abschnitt Wiki-Seiten listet sie (siehe Wiki).
Personen und Bots werden nur gefunden, solange ihr Konto aktiv ist. Views sucht werkbuch über jedes Wort ihres Namens, ohne Rücksicht auf Groß- und Kleinschreibung und Akzente, direkt in der Datenbank: Eine neue View wird sofort gefunden.
Wer was findet
- Nur, was du sehen darfst. Items, Seiten und Projekte kommen nur aus Projekten, die du sehen darfst, entschieden im Moment der Suche, nicht beim Indexieren. Wer aus einem privaten Projekt entfernt wird oder wessen Projekt privat wird, findet ab dann keins seiner Items und keine seiner Seiten mehr, auch bevor der Index nachzieht. Ein gelöschtes Item, eine gelöschte Seite oder etwas, dessen Projekt gerade gelöscht wird, erscheint nie.
- Archiv wie in Listen. Ohne
include_archivedlässt die Suche archivierte Items und die Items, Seiten und Projekte archivierter Projekte weg, wie jede Item-Liste. Die Palette sucht immer so. - Ein Key springt. Eine Eingabe in Key-Form wie
WEB-47oderweb-47nennt ihr Item inkey_matchund stellt es nach vorn, archiviert oder nicht. Eine frühere Kennung geht auch: Nachdem aus WEB SITE wurde, findetWEB-47weiter SITE-47. Das gilt nur für ein Item, das du siehst; der Key jedes anderen Items antwortet genau wie ein Key, den es nicht gibt. - Personen. Die API liefert Personen und Bots jedem Konto, wie die Liste der Konten. Die Palette zeigt sie nur Org-Admins, weil ein Treffer in die Einstellungen der Personen und Bots führt, die nur Org-Admins öffnen.
- Views findet jedes Konto; jedes Konto darf jede View lesen.
Befehlspalette
⌘ / Strg+K öffnet die Palette auf jedem Bildschirm. / öffnet sie auch, außer in Item-Listen: Dort sucht / im Titel der Liste. Ebenso öffnen sie der Knopf Suchen … oben in der Seitenleiste, das Such-Icon der eingeklappten Seitenleiste und der Leiste am Handy und Suchen auf der Seite „nicht gefunden“.
Was du tippst, trifft zuerst die Befehle (über Name, Gruppe und Stichwörter), danach folgen die Suchtreffer in Abschnitten: Items (bis zu 8), Seiten, Projekte, Personen und Views (je bis zu 4). Eine Seite zeigt Emoji, Titel und Projekt und öffnet sich im Wiki. Die Suche startet 150 ms nach der letzten Taste; solange sie läuft, sagt die Palette „Suche läuft …“. ↑ und ↓ wählen einen Treffer, ↵ öffnet ihn, Esc schließt die Palette.
Ein getippter Key wie WEB-47 stellt die Items nach vorn, ganz oben WEB-47 öffnen: ↵ springt dorthin, auch bevor die Suche geantwortet hat. Gehört der Key über eine frühere Kennung zu einem Item, das du siehst, steht stattdessen dieses Item vorn.
Ohne Treffer sagt die Palette das und gibt zwei Tipps: Befehle findest du über ihren Namen, und ein Key springt direkt zum Item. Antwortet die Suche nicht, zeigt die Palette den Grund mit Erneut versuchen; ein getippter Key springt trotzdem, weil die Item-Seite den Key selbst auflöst.
Der Dialog Relation hinzufügen (R an einem Item) findet das andere Item über dieselbe Suche (nur Items, bis zu 20), Keys eingeschlossen. Bevor du tippst, schlägt er nichts vor. # in einem Text findet Items und Seiten genauso (siehe Rich Text).
Alle Tasten der Palette stehen auf der Seite Tastatur.
REST
GET /api/v1/search braucht ein Token mit read (oder die Sitzung der Oberfläche); Tokens, Fehler und Grenzen erklärt die Seite REST-API.
| Parameter | Wert |
|---|---|
q | Pflicht. Wonach gesucht wird, 1 bis 255 Zeichen nach dem Trimmen. |
types | Die Arten, in denen gesucht wird: items, pages, projects, people, views, durch Komma getrennt (types=items,projects) oder als Liste (types[]=items). Weggelassen alle fünf; eine Liste ohne jede Art (types=,) ist ein 422. |
limit | Treffer je Art, 1 bis 50; Standard 20. |
include_archived | 1 oder true durchsucht auch archivierte Items und archivierte Projekte samt ihren Items und Seiten. |
type_id | Nur Items dieser Typen (ULIDs). |
state_category | Nur Items, deren Status in einer dieser Kategorien liegt: backlog, unstarted, started, completed, canceled. |
assignee_id | Nur Items, die einem dieser Konten zugewiesen sind (ULIDs), oder none allein: Items ohne Assignee. |
label_id | Nur Items mit einem dieser Labels (ULIDs). |
Die letzten vier engen nur die Items ein, nie Seiten, Projekte, Personen oder Views. Jeder nimmt einen Wert, mehrere durch Komma oder eine Liste; mehrere Werte eines Parameters heißen „einer davon“, mehrere Parameter müssen alle gelten. Jeder andere Parameter wird übergangen. Seiten gibt es nicht: Frag nach einem größeren limit oder einem engeren q. Über MCP nimmt das Tool search dieselben Parameter, Listen als JSON-Listen.
curl -H "Authorization: Bearer <Token>" \
  "https://werkbuch.example.com/api/v1/search?q=kontakt&types=items,projects&limit=5"
Die Antwort hat immer alle sechs Schlüssel; Arten, nach denen du nicht gefragt hast, sind leere Listen. Items kommen in der schlanken Form der Listen, ohne description, description_json und values_markdown, Seiten in der schlanken Form des Baums, ohne content und content_json; Projekte, Personen und Views haben die Form ihrer eigenen Endpunkte.
{
  "data": {
    "items": [
      {
        "id": "01m6akyecnp503vn6jmb8sp249",
        "key": "WEB-47",
        "title": "Kontaktformular sendet doppelt",
        "state_id": "01m6akx71bcm10xw328kxkw7ak",
        "archived_at": null,
        "…": "…"
      }
    ],
    "pages": [],
    "projects": [],
    "people": [],
    "views": [],
    "key_match": null
  }
}
key_match ist die ULID des Items, das ein q in Key-Form nennt, wenn du es siehst und es die Filter der Items erfüllt, sonst null. Gesetzt wird es nur, wenn types auch items enthält, und das Item steht dann vorn in items.
Fehler
Eine Anfrage, die nicht passt, ist ein 422 mit allen Problemen auf einmal, an q, types, limit, include_archived oder einem der Filter (ein Wert, der keine ULID ist, eine unbekannte Kategorie, none neben einem Konto):
{
  "type": "urn:werkbuch:problem:validation_failed",
  "title": "Validierung fehlgeschlagen",
  "status": 422,
  "detail": "Die Eingabe ist nicht gültig.",
  "reason": "validation_failed",
  "errors": {
    "q": ["Gib einen Suchbegriff ein."],
    "limit": ["Eine ganze Zahl von 1 bis 50."]
  }
}
Antwortet die Suchmaschine nicht, ist die Suche ein 503 statt einer leeren Liste; ein fehlender Treffer sieht so nie aus wie „nichts gefunden“:
{
  "type": "urn:werkbuch:problem:search_unavailable",
  "title": "Dienst nicht verfügbar",
  "status": 503,
  "detail": "Die Suche ist gerade nicht erreichbar. Versuch es gleich noch einmal.",
  "reason": "search_unavailable"
}
Ein Token ohne read bekommt ein 403, eine Anfrage ohne Konto ein 401. Meldungen kommen in der Sprache des Kontos.
Betrieb
werkbuch sucht mit Meilisearch über Laravel Scout. Lokal läuft es in DDEV als Dienst meilisearch (siehe Entwicklung); im Docker-Compose-Stack ist es der Dienst meilisearch (siehe Einrichtung).
| Variable | Bedeutung |
|---|---|
SCOUT_DRIVER | meilisearch; null schaltet den Index ab, Suchen finden dann nur noch einen getippten Key. |
MEILISEARCH_HOST | Adresse von Meilisearch, wie werkbuch es erreicht, zum Beispiel http://meilisearch:7700. |
MEILISEARCH_KEY | Ein Schlüssel, der Indizes anlegen, füllen und einstellen darf (der Master-Key oder ein Admin-Key). Er verlässt nie den Server. |
SCOUT_PREFIX | Steht vor den Index-Namen work_items, pages, projects und users; leer für die App. Zwei Installationen auf einem Meilisearch brauchen verschiedene Präfixe. |
Der Index folgt den Events. Jede Änderung in werkbuch schreibt ein Event; ein Konsument in der Queue search aktualisiert daraus den Index. Ein Queue-Worker muss deshalb auf search hören, und eine Änderung erscheint einen Moment später in der Suche. Änderungen, die viele Items auf einmal betreffen (eine neue Kennung eines Projekts, ein geänderter Workflow, ein gelöschtes Label), bauen die Dokumente dieser Items in einem eigenen Job in derselben Queue neu; das Löschen einer Wiki-Seite nimmt ihren ganzen Teilbaum auf einmal aus dem Index.
Kommandos.
php artisan app:search-sync      # schickt die Einstellungen der Indizes an Meilisearch (nach einem Update, das sie geändert hat)
php artisan app:search-import    # baut die vier Indizes neu aus der Datenbank auf und tauscht sie ein
app:search-import ist der erste Start und die Reparatur: Es baut jeden Index neu aus der Datenbank auf, neben dem, den die Suche liest (work_items_next neben work_items, mit den Einstellungen), tauscht dann die beiden und löscht den alten. Die Suche antwortet währenddessen weiter aus den alten Dokumenten; scheitert der Aufbau, bleibt der alte Index und der neue wird gelöscht. Änderungen, die kommen, während ein Index aufgebaut wird, landen zuerst im alten; am Ende schreibt der Import alles, was sich seit kurz vor seinem Start geändert hat, noch einmal, so geht mit dem Tausch nichts verloren. Er fasst nur Indizes an, die mit SCOUT_PREFIX beginnen; andere Indizes auf demselben Meilisearch bleiben. In DDEV stellst du beiden ddev artisan voran.
Nach einem Update, das ändert, was der Index enthält, führst du einmal app:search-sync aus: Ohne das durchsucht Meilisearch die neuen Felder nicht. Das Update, mit dem Kommentare durchsuchbar wurden, ist so eins; führe danach auch app:search-import aus, damit die Kommentare von vor dem Update in den Index kommen. Das Update mit dem Wiki bringt den Index pages: Bis app:search-sync ihn angelegt hat, antwortet jede Suche ohne types mit 503, und app:search-import bringt die vorhandenen Seiten hinein.
Fällt Meilisearch aus, antwortet die Suche mit 503, und die Palette sagt „Die Suche hat nicht geantwortet“ mit Erneut versuchen; der Sprung zu einem getippten Key funktioniert weiter. Unterwegs geht nichts verloren: Der Konsument versucht jedes Event bis zu 8-mal, mit Pausen von 10 Sekunden, 1, 5 und 15 Minuten und dann je einer Stunde, insgesamt rund 3 Stunden 20 Minuten. Danach landet der Job in failed_jobs, und werkbuch meldet, bei welchem Event die Suche aufgegeben hat. Läuft Meilisearch wieder, ruf app:search-import auf, und der Index ist wieder vollständig.
Im Docker-Compose-Stack ruft jeder Start von werkbuch app:search-sync und importiert, wenn ein Index leer ist oder ihm Felder der neuen Version fehlen; ein Update braucht also nichts von Hand (Betrieb).
Meilisearch hält seine Indizes in Dateien, die es in den Speicher abbildet, und braucht freien Arbeitsspeicher: Beim Indexieren nimmt es bis zu zwei Drittel des RAM. Die Mindestanforderungen des Stacks und wie man den Speicher von Meilisearch begrenzt, stehen unter Einrichtung.